Point clé
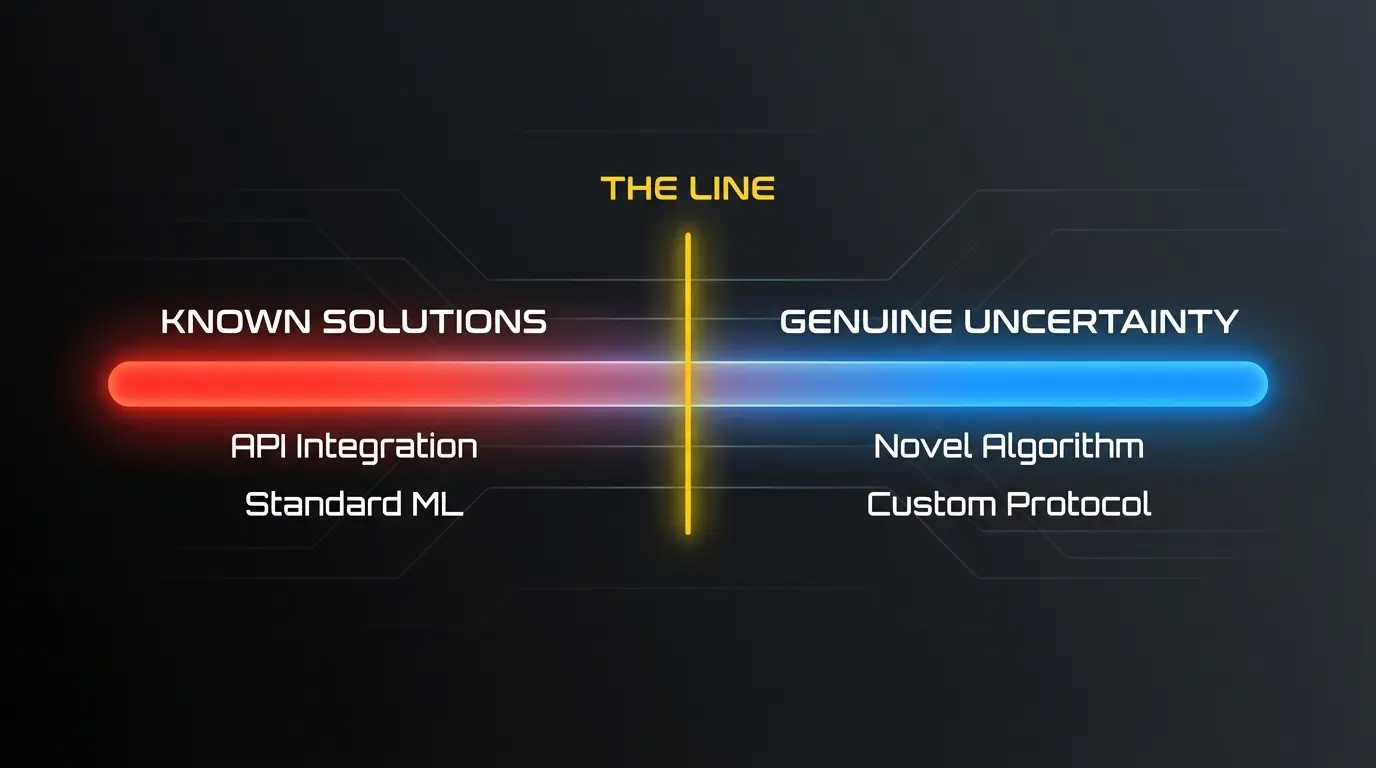
La ligne entre le travail RS&DE admissible et non admissible n'est pas une question de difficulté ou d'effort. C'est de savoir si un praticien qualifié aurait pu prédire le résultat à partir des connaissances existantes. Ces 10 exemples montrent exactement où se situe cette ligne.
Le test en trois volets de la RS&DE se lit assez clairement : incertitude technologique, investigation systématique, avancement technologique. Puis vous regardez un tableau de sprint et essayez de l’appliquer.
C’est là que la plupart des entreprises bloquent. Ce qui aide, ce n’est pas une explication plus poussée des critères. Ce sont des exemples.
En voici 10, du clairement admissible au clairement exclu, avec le raisonnement qu’applique l’ARC à chacun. Pour le cadre complet, voyez les activités RS&DE admissibles pour les entreprises logicielles.
Exemple 1 : algorithme inédit de détection d’anomalies en temps réel
Ce que l’équipe a fait : Une plateforme de commerce en ligne devait détecter les transactions frauduleuses en moins de 50 ms. Plus lent, et des paiements légitimes sont bloqués. Les approches existantes dépassaient la cible de latence ou rejetaient trop de vrais clients. L’équipe a passé trois mois à tester si un hybride de références statistiques et d’inférence ML légère pouvait respecter les deux contraintes à la fois.
Est-ce admissible? Oui.
Pourquoi : L’incertitude était réelle. Aucune approche publiée ne couvrait cette combinaison de cible de latence et de tolérance aux faux positifs à leur volume de transactions. Le travail était systématique : des hypothèses précises sur les architectures pouvant tenir dans le budget de latence, testées contre des repères définis, avec les raisons documentées de chaque rejet.
La documentation qui compte : La méthodologie de référence. Les mesures de latence et de faux positifs à chaque étape. Une explication écrite des lacunes des approches publiées.
Exemple 2 : implanter un algorithme de recommandation standard
Ce que l’équipe a fait : Un détaillant a ajouté des recommandations de produits par filtrage collaboratif. Six semaines à intégrer une bibliothèque, ajuster des paramètres et faire des tests A/B de positionnement.
Est-ce admissible? Non.
Pourquoi : Un praticien qualifié aurait pu y arriver à partir des connaissances existantes. Le filtrage collaboratif est bien documenté. Les implantations libres sont partout. L’ajustement et les tests de positionnement sont de la pratique courante.
La ligne : Appliquer habilement des méthodes connues n’est pas de la RS&DE. La réponse doit être réellement introuvable dans la littérature.
Exemple 3 : enquêter sur une corruption mémoire dans un moteur maison
Ce que l’équipe a fait : Une entreprise fintech avait bâti un moteur de traitement de transactions en C++ pour la vitesse. Après déploiement, elle a rencontré une corruption mémoire intermittente sous certaines charges, causant des erreurs silencieuses. Les débogueurs standards ne la reproduisaient pas de façon fiable.
L’équipe a passé huit semaines à construire une instrumentation sur mesure captant l’état mémoire aux microsecondes. Elle a testé plusieurs hypothèses de conditions de course dans ses structures de données sans verrou. La cause s’est avérée être une interaction entre son allocateur mémoire et le comportement de cohérence de cache du processeur.
Est-ce admissible? Oui.
Pourquoi : Cette interaction n’était documentée nulle part pour leur architecture. L’investigation a suivi une méthode claire : formuler une hypothèse, construire l’instrumentation, mener des expériences contrôlées, consigner les résultats. La connaissance obtenue n’existait pas avant qu’ils la cherchent.
La documentation qui compte : Chaque hypothèse et l’expérience conçue pour la tester. L’instrumentation elle-même. La progression de la compréhension à mesure que des pistes étaient écartées.
Exemple 4 : correction de bogue par procédures de débogage standards
Ce que l’équipe a fait : Les ingénieurs ont passé 40 heures sur une condition de course dans une API Node.js causant des erreurs 500 intermittentes sous charge. Ils ont utilisé l’inspecteur Node, les traces de pile asynchrones et un banc de test de charge, trouvé un mutex manquant autour d’une cache partagée, et corrigé.
Est-ce admissible? Non.
Pourquoi : Outils connus, classe de problème connue, solution connue. Les conditions de course en programmation concurrente sont parfaitement comprises, et protéger un état partagé par un mutex est du manuel.
La distinction : C’était du travail difficile fait par des ingénieurs compétents. La difficulté n’est pas le critère. L’incertitude l’est. Quarante heures à appliquer des techniques connues, ça reste appliquer des techniques connues.
Exemple 5 : créer un format de compression inédit pour appareils embarqués
Ce que l’équipe a fait : Une entreprise IdO devait transmettre de la télémétrie depuis des appareils dotés de 8 Ko de RAM sur un réseau 2G. Les formats de compression existants étaient soit trop coûteux pour ce matériel, soit insuffisants pour leur structure de données. Cinq mois à développer et valider un schéma sur mesure adapté aux propriétés statistiques de leurs données de capteurs.
Est-ce admissible? Oui.
Pourquoi : Aucun format existant ne respectait à la fois le budget mémoire et le taux de compression pour ce type de données. Le travail comportait des cibles de performance définies, des repères contrôlés et des résultats documentés pour chaque approche essayée. Le résultat est un artéfact technique réellement nouveau.
La documentation qui compte : Les contraintes matérielles et les cibles de performance. Les comparatifs avec les formats existants démontrant leur insuffisance. Les résultats expérimentaux à chaque étape.
Exemple 6 : optimiser un modèle ML avec des techniques standards
Ce que l’équipe a fait : Une entreprise SaaS a affiné un modèle de langage pré-entraîné sur son propre jeu de données. Deux mois d’optimisation d’hyperparamètres, de calendriers de taux d’apprentissage, de tailles de lots et de régularisation, évalués sur un jeu de test réservé.
Est-ce admissible? Non.
Pourquoi : L’affinage avec optimisation d’hyperparamètres est une pratique établie. Les techniques sont documentées et l’outillage est prêt à l’emploi. De nouvelles données ne créent pas à elles seules une incertitude technologique.
L’exception possible : Si l’affinage avait révélé un mode de défaillance précis exigeant une investigation originale pour être diagnostiqué, et que la littérature ne le couvrait pas, cette investigation pourrait être admissible. L’affinage de routine autour, non.
Exemple 7 : concevoir un mécanisme de consensus distribué inédit
Ce que l’équipe a fait : Une entreprise d’infrastructure blockchain visait une finalité sous deux secondes en tolérant 33 % de nœuds byzantins défaillants. PBFT, Tendermint et HotStuff échouaient chacun sur une contrainte ou l’autre à leur échelle de réseau. Huit mois à modifier HotStuff, à tester les propriétés de sécurité contre des modèles de menace formels et à valider la performance par simulation.
Est-ce admissible? Oui.
Pourquoi : Aucun protocole publié ne satisfaisait cet espace de contraintes. L’investigation a combiné analyse formelle de sécurité et tests empiriques de performance, ce qui est à peu près le maximum de rigueur possible. Le résultat étend l’état des connaissances en systèmes distribués.
La documentation qui compte : L’analyse de contraintes montrant l’insuffisance des protocoles existants. L’analyse formelle de sécurité des modifications proposées. La méthodologie et les résultats de simulation.
Exemple 8 : intégrer des API existantes pour une nouvelle fonctionnalité
Ce que l’équipe a fait : Un SaaS de gestion de projets a ajouté une intégration Slack. Trois semaines à lire la documentation de l’API Slack, gérer les webhooks, bâtir une interface de configuration et tester de bout en bout.
Est-ce admissible? Non.
Pourquoi : L’API Slack est abondamment documentée. Un développeur qualifié l’implante en suivant la documentation. Il n’y a pas d’investigation, seulement de la lecture et de la construction.
L’exception possible : Si l’intégration avait exposé un comportement d’API non documenté exigeant une investigation originale, cette partie pourrait être admissible. L’intégration elle-même, non.
Exemple 9 : un optimiseur de requêtes sur mesure pour données éparses
Ce que l’équipe a fait : Une entreprise d’analytique géospatiale exécutait des requêtes analytiques sur des données géographiques éparses et irrégulières. PostgreSQL, BigQuery et Snowflake produisaient tous de mauvais plans, parce que leurs modèles de coûts présument des propriétés que les données géospatiales éparses n’ont pas.
Six mois à chercher si une couche de planification sur mesure, consciente de leur distribution de données, pouvait battre les planificateurs généraux. Ils ont formulé des hypothèses de modèle de coûts, bâti un prototype et l’ont validé contre des repères représentatifs de la production.
Est-ce admissible? Oui.
Pourquoi : L’hypothèse était précise et testable, et l’échec des planificateurs généraux était documentable. La littérature sur l’optimisation de requêtes ne réglait pas leur cas. Une couche de planification spécialisée avec des modèles de coûts modifiés constitue un véritable avancement.
La documentation qui compte : Les repères montrant l’insuffisance des planificateurs généraux. Les hypothèses de modèle de coûts testées. Les mesures de performance à chaque étape.
Exemple 10 : une investigation ratée qui n’a rien donné
Ce que l’équipe a fait : Une entreprise de santé numérique a testé si un raisonnement hybride neuro-symbolique pouvait battre le ML pur en précision diagnostique sur son jeu de données cliniques. Quatre mois, cinq architectures hybrides, des expériences contrôlées contre un repère clinique. Aucune n’a battu le modèle existant. Le projet a été abandonné.
Est-ce admissible? Oui.
Pourquoi : La RS&DE exige une véritable investigation, pas un succès. Personne ne savait si le raisonnement hybride surpasserait le ML pur sur cette tâche, et la littérature ne pouvait pas le dire. La méthode était solide : hypothèses définies, expériences contrôlées, résultats documentés. Découvrir que ces approches ne battent pas la référence est en soi une connaissance. L’ARC reconnaît explicitement que les expériences ratées peuvent être admissibles.
La documentation qui compte : Chaque architecture évaluée et l’hypothèse qui la sous-tend. La méthodologie de comparaison. Les journaux d’expérimentation. Un récit clair des raisons d’abandon de chaque piste.
Quel est le motif commun?
Les cas admissibles partagent trois propriétés.
L’incertitude était précise. Pas « on n’était pas sûrs que ça marche ». Plutôt « cette combinaison de contraintes n’est traitée par aucune approche publiée, et voici la preuve ».
L’investigation avait une structure. Pas « on a essayé des choses ». Une progression documentée : hypothèse, test, résultat, hypothèse suivante.
La documentation existait déjà. La trace de ce qui a été essayé a été captée pendant le travail, pas assemblée de mémoire en mars.
Les cas non admissibles échouent tous au premier test. La réponse était disponible. Appliquer des algorithmes connus, implanter des API documentées, ajuster des architectures établies. C’est de l’ingénierie compétente. Ce n’est pas de la recherche.
Voici l’erreur la plus fréquente des entreprises logicielles : déposer sur la base de l’effort et de la complexité plutôt que de l’incertitude et de l’investigation. Le travail difficile n’est pas de la RS&DE. La question est de savoir si un ingénieur qualifié, avec les connaissances existantes, aurait pu annoncer le résultat avant le début des travaux.
Foire aux questions
Le travail d’ingénierie difficile est-il automatiquement admissible?
Non. La difficulté et l’effort ne sont pas les critères. Le test est de savoir si un ingénieur qualifié, avec les connaissances publiques existantes, aurait pu prédire le résultat. Implanter des API documentées ou ajuster des modèles établis n’est pas admissible, peu importe le nombre d’heures.
Un projet raté peut-il quand même être admissible?
Oui. L’ARC reconnaît explicitement les expériences ratées. Si l’incertitude était réelle et l’investigation systématique, découvrir qu’une approche ne fonctionne pas est un avancement technologique. L’exemple 10 couvre exactement ce cas.
Quelle documentation fait la différence?
Les hypothèses testées à chaque étape, les repères montrant l’insuffisance des approches existantes, les journaux de ce qui a été essayé et observé, et un récit clair des raisons de poursuivre ou d’abandonner chaque piste. Les traces faites pendant le travail pèsent bien plus lourd qu’un narratif rédigé des mois plus tard.
Vous voulez de l’aide pour repérer le travail admissible dans votre équipe? Parlez à notre équipe de l’automatisation de votre documentation RS&DE à partir de vos outils de développement.